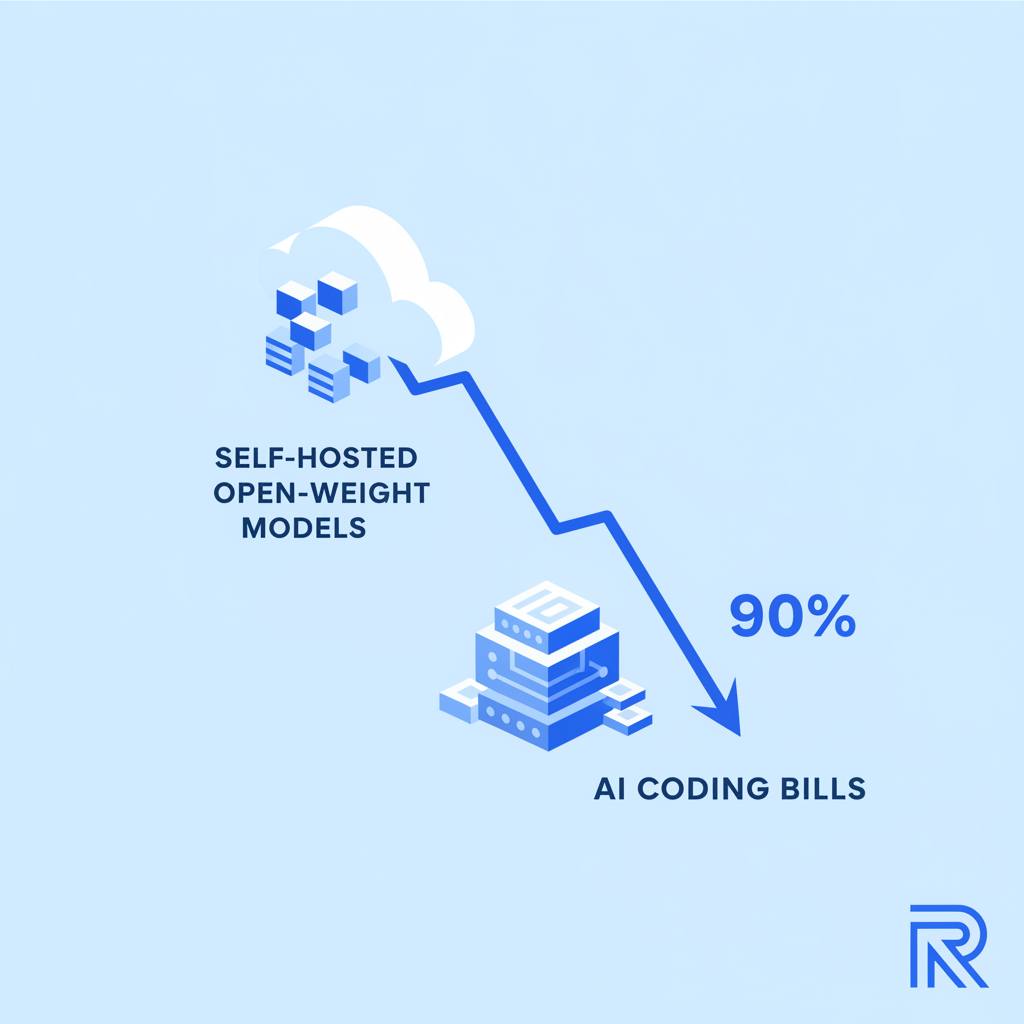
حققت شركة التكنولوجيا المالية ريفولوت توفيراً كبيراً في تكاليف برمجة الذكاء الاصطناعي بنسبة 90%. بدلاً من الاعتماد على النماذج الجاهزة باهظة الثمن، استضافت الشركة نماذج ذكاء اصطناعي مفتوحة الوزن ذاتياً، مما سرّع عملية البرمجة أيضاً.
تخيل أنك تدفع فواتير ضخمة مقابل شيء لا يحقق لك العائد المرجو منه. هذا بالضبط ما واجهته شركة التكنولوجيا المالية البريطانية ريفولوت مع مساعدي البرمجة بالذكاء الاصطناعي. لقد تضخمت فواتيرهم بشكل كبير، حيث كان بعض المهندسين ينفقون ما يصل إلى 10 آلاف دولار شهرياً على 'رموز الذكاء الاصطناعي' دون نتائج واضحة. لكن ريفولوت وجدت حلاً مبتكراً، وهذا يحمل دروساً مهمة لكل الشركات التي تستخدم الذكاء الاصطناعي: أن التوفير الكبير والسرعة يمكن تحقيقهما بطرق غير تقليدية.
بدأت ريفولوت تجربتها في أوائل عام 2025 مع Gemini، ثم Claude Code في أوائل عام 2026، لكن التكاليف خرجت عن السيطرة، بينما كان الأثر الفعلي متواضعاً. فماذا فعلوا؟ اتخذوا خطوة جريئة في أبريل 2026: تخلوا عن الاعتماد الأساسي على واجهات برمجة التطبيقات المتطورة باهظة الثمن، وبدأوا في استضافة نماذج ذكاء اصطناعي مفتوحة الوزن بأنفسهم. بدأوا بنموذج GLM-5.1 من مختبر Z.ai الصيني، ثم طوروا إلى GLM-5.3، الذي يعمل الآن على حوالي 56 وحدة معالجة رسوميات من نوع Nvidia B200.
وكانت النتائج مذهلة: انخفاض بنسبة 90% في تكاليف استدلال برمجة الذكاء الاصطناعي، مما يعني توفيراً هائلاً. لم يتوقف الأمر عند التوفير المالي فحسب، بل تحسنت سرعة البرمجة بنسبة 60%، ووقت إنجاز العمل (من البدء حتى الدمج) بنسبة 70% لـ 2000 مهندس لديهم. حتى أنهم لاحظوا زيادة بنسبة 76% في عدد الطلبات بالثانية بعد الضبط، وتقليلاً بنسبة 88% في وقت الوصول للرمز الأول (من 14.3 ثانية إلى 1.7 ثانية).
الأمر الأكثر إثارة للاهتمام هو أن النماذج القديمة مثل Claude Code وOpenAI's Codex لم تختفِ تماماً، بل أصبحت 'استثناءً'، تُستخدم فقط عندما لا يستطيع النموذج المستضاف ذاتياً أداء المهمة، خاصةً في أعمال واجهة المستخدم والمشكلات الأكثر تعقيداً حيث أن GLM يعالج النصوص فقط. والدرس الأهم هنا، كما تقول ريفولوت، هو أن «الرموز الرخيصة وغير المحدودة، وليست الذكاء الاصطناعي الأذكى، هي ما تسرّع عملية البرمجة». هذا يفتح آفاقاً جديدة للشركات لتقليل التكاليف وزيادة الإنتاجية دون التضحية بالجودة.
بدأت ريفولوت تجربتها في أوائل عام 2025 مع Gemini، ثم Claude Code في أوائل عام 2026، لكن التكاليف خرجت عن السيطرة، بينما كان الأثر الفعلي متواضعاً. فماذا فعلوا؟ اتخذوا خطوة جريئة في أبريل 2026: تخلوا عن الاعتماد الأساسي على واجهات برمجة التطبيقات المتطورة باهظة الثمن، وبدأوا في استضافة نماذج ذكاء اصطناعي مفتوحة الوزن بأنفسهم. بدأوا بنموذج GLM-5.1 من مختبر Z.ai الصيني، ثم طوروا إلى GLM-5.3، الذي يعمل الآن على حوالي 56 وحدة معالجة رسوميات من نوع Nvidia B200.
وكانت النتائج مذهلة: انخفاض بنسبة 90% في تكاليف استدلال برمجة الذكاء الاصطناعي، مما يعني توفيراً هائلاً. لم يتوقف الأمر عند التوفير المالي فحسب، بل تحسنت سرعة البرمجة بنسبة 60%، ووقت إنجاز العمل (من البدء حتى الدمج) بنسبة 70% لـ 2000 مهندس لديهم. حتى أنهم لاحظوا زيادة بنسبة 76% في عدد الطلبات بالثانية بعد الضبط، وتقليلاً بنسبة 88% في وقت الوصول للرمز الأول (من 14.3 ثانية إلى 1.7 ثانية).
الأمر الأكثر إثارة للاهتمام هو أن النماذج القديمة مثل Claude Code وOpenAI's Codex لم تختفِ تماماً، بل أصبحت 'استثناءً'، تُستخدم فقط عندما لا يستطيع النموذج المستضاف ذاتياً أداء المهمة، خاصةً في أعمال واجهة المستخدم والمشكلات الأكثر تعقيداً حيث أن GLM يعالج النصوص فقط. والدرس الأهم هنا، كما تقول ريفولوت، هو أن «الرموز الرخيصة وغير المحدودة، وليست الذكاء الاصطناعي الأذكى، هي ما تسرّع عملية البرمجة». هذا يفتح آفاقاً جديدة للشركات لتقليل التكاليف وزيادة الإنتاجية دون التضحية بالجودة.