تكتشف فحوصات الكود بالذكاء الاصطناعي ثغرات صلاحيات الوصول الحرجة التي تفوتها الاختبارات التقليدية، لأنها تنظر مباشرة إلى بنية الكود وليس فقط ما يظهر للمستخدم.
مرحباً بكم في WondTech! هل تعلم أن بعض أخطر الثغرات الأمنية في تطبيقات الويب يمكن أن تتجاوز حتى أدق الفحوصات الأمنية؟ إننا نتحدث هنا عن ثغرات صلاحيات الوصول، وهي تلك المشاكل التي تسمح لمستخدم واحد برؤية بيانات مستخدم آخر أو الوصول إلى ميزات لا ينبغي له استخدامها. النبأ السار هو أن تدقيق الكود بالذكاء الاصطناعي يقدم حلاً لاكتشاف هذه المشكلات التي تفوتها الاختبارات التقليدية.
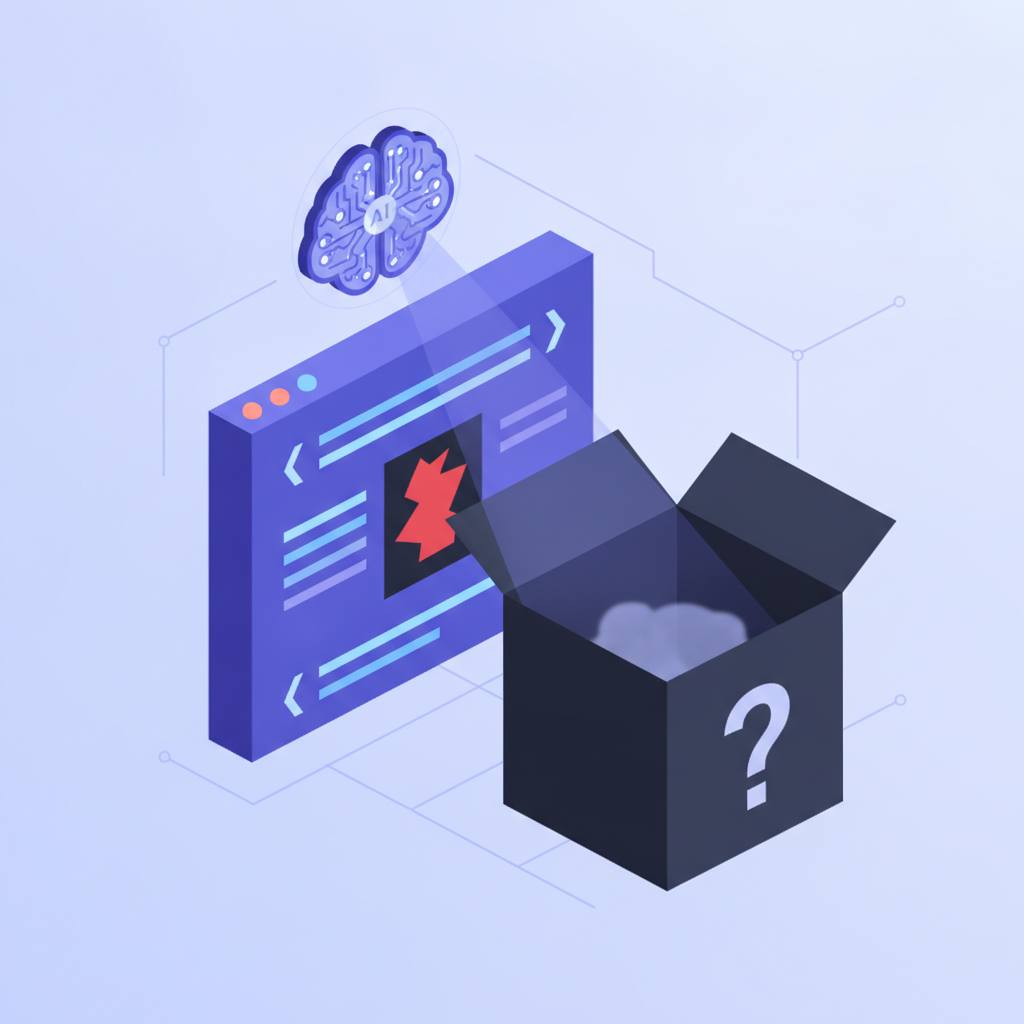
ماذا يعني هذا بالنسبة لك؟ ببساطة، يعني تطبيقات أكثر أماناً وبيانات محمية بشكل أفضل. الاختبارات الأمنية التقليدية، التي نسميها «الاختبارات الصندوقية السوداء»، تعمل وكأنها مخترق خارجي. ترسل هذه الاختبارات طلبات إلى نظامك الحي وتراقب الاستجابات. يمكن لبرنامج زحف (crawler) أن يقضي أسبوعاً كاملاً في استكشاف تطبيق ويب وينتج تقريراً نظيفاً تماماً، ومع ذلك يفشل في اكتشاف ثغرة تسمح لمستأجر واحد بقراءة فاتورة مستأجر آخر! هذه الثغرة ليست مخفية؛ بل هي ببساطة غير قابلة للوصول من الخارج. الاختبار الصندوقي الأسود يرى فقط ما تُرجعه هذه الثغرة، لا كيف تم اتخاذ قرار الإرجاع أصلاً.
هنا يتدخل تدقيق الكود بالذكاء الاصطناعي. هذا النوع من التدقيق يذهب إلى أعمق من ذلك بكثير. إنه يقرأ الكود المصدري الفعلي، المسارات، قواعد الصلاحيات، وتدفق البيانات. يمكنه أن يرى السطر البرمجي الذي يقرر من يمكنه الوصول إلى سجل معين. تخيل معي: من الخارج، تبدو طريقة عرض السجل متطابقة، سواء كانت قد قامت بالتحقق الصحيح من الملكية أو ورثت إذناً خاطئاً من تحديث برمجي سابق. فقط تحليل الكود يكشف الحقيقة.
الجميل في الأمر هو أن هذين النهجين لا يلغي أحدهما الآخر؛ بل يكملان بعضهما. الاختبارات الصندوقية السوداء رائعة في العثور على الأخطاء التي يمكنها تشغيلها وتأكيدها في نظام مباشر. تدقيق الكود بالذكاء الاصطناعي يتفوق في العثور على التحققات المفقودة أو المعكوسة التي قد لا تصلها أدوات الزحف الخارجية أبداً، مثل المسارات المحمية بعلامات أو أدوار أو نقاط نهاية داخلية. من أجل أمان تطبيقات قوي حقاً، نحتاج إلى كلا الأسلوبين معاً. فهما يحللان أدلة مختلفة ويتوصلان إلى استنتاجات مختلفة، مما يجعلهما شريكين أقوياء في حماية تطبيقاتنا.
ماذا يعني هذا بالنسبة لك؟ ببساطة، يعني تطبيقات أكثر أماناً وبيانات محمية بشكل أفضل. الاختبارات الأمنية التقليدية، التي نسميها «الاختبارات الصندوقية السوداء»، تعمل وكأنها مخترق خارجي. ترسل هذه الاختبارات طلبات إلى نظامك الحي وتراقب الاستجابات. يمكن لبرنامج زحف (crawler) أن يقضي أسبوعاً كاملاً في استكشاف تطبيق ويب وينتج تقريراً نظيفاً تماماً، ومع ذلك يفشل في اكتشاف ثغرة تسمح لمستأجر واحد بقراءة فاتورة مستأجر آخر! هذه الثغرة ليست مخفية؛ بل هي ببساطة غير قابلة للوصول من الخارج. الاختبار الصندوقي الأسود يرى فقط ما تُرجعه هذه الثغرة، لا كيف تم اتخاذ قرار الإرجاع أصلاً.
هنا يتدخل تدقيق الكود بالذكاء الاصطناعي. هذا النوع من التدقيق يذهب إلى أعمق من ذلك بكثير. إنه يقرأ الكود المصدري الفعلي، المسارات، قواعد الصلاحيات، وتدفق البيانات. يمكنه أن يرى السطر البرمجي الذي يقرر من يمكنه الوصول إلى سجل معين. تخيل معي: من الخارج، تبدو طريقة عرض السجل متطابقة، سواء كانت قد قامت بالتحقق الصحيح من الملكية أو ورثت إذناً خاطئاً من تحديث برمجي سابق. فقط تحليل الكود يكشف الحقيقة.
الجميل في الأمر هو أن هذين النهجين لا يلغي أحدهما الآخر؛ بل يكملان بعضهما. الاختبارات الصندوقية السوداء رائعة في العثور على الأخطاء التي يمكنها تشغيلها وتأكيدها في نظام مباشر. تدقيق الكود بالذكاء الاصطناعي يتفوق في العثور على التحققات المفقودة أو المعكوسة التي قد لا تصلها أدوات الزحف الخارجية أبداً، مثل المسارات المحمية بعلامات أو أدوار أو نقاط نهاية داخلية. من أجل أمان تطبيقات قوي حقاً، نحتاج إلى كلا الأسلوبين معاً. فهما يحللان أدلة مختلفة ويتوصلان إلى استنتاجات مختلفة، مما يجعلهما شريكين أقوياء في حماية تطبيقاتنا.