يعتقد الكثيرون أن إضافة Schema كافٍ لظهور صفحاتهم في ملخصات الذكاء الاصطناعي، لكن الأهم هو أن تتطابق بيانات JSON-LD مع المحتوى الظاهر على الصفحة. فالتناقضات أو تحميل Schema عبر JavaScript قد تربك الذكاء الاصطناعي، مما يجعل الفهرسة الصحيحة وتوافق المحتوى ضروريين للاستشهاد الدقيق.
كثيرون منا يسمعون عن «إعداد مخطط الأسئلة الشائعة» ثم يقومون بلصق كتلة من بيانات JSON-LD ويعتقدون أنهم قد انتهوا من تحسين محركات البحث لملخصات الذكاء الاصطناعي. لكن الحقيقة مختلفة جدًا. إذًا، ماذا يعني هذا بالنسبة لك؟
غالبًا ما نجد أن أداة اختبار النتائج المنسقة من Google تشير إلى أن Schema صالح، لكن الأسئلة على الصفحة مكتوبة بطريقة مطولة، أو أن الإجابات في Schema مختلفة تمامًا عما يراه القارئ، أو أن كتلة البيانات بأكملها تُضاف فقط بعد تشغيل JavaScript. في هذه الحالات، لن يساعد Schema الذكاء الاصطناعي على استخلاص المعلومات بشكل صحيح؛ بل يضيف فقط طبقة من البيانات يسهل أن تتعارض. هذا لا يخدم هدفك في الظهور بشكل جيد على محركات البحث المدعومة بالذكاء الاصطناعي.
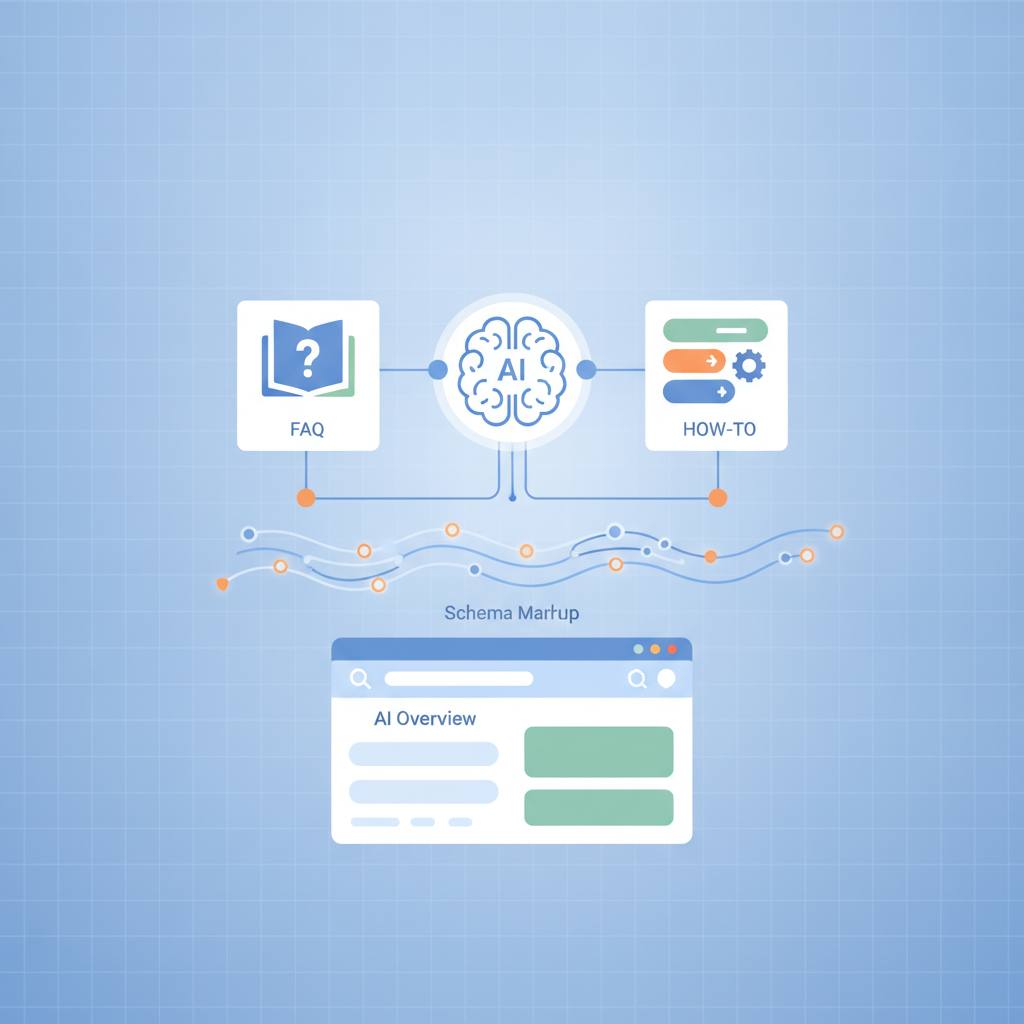
تركز هذه النصائح على نوعين من Schema المستخدمين على نطاق واسع في صفحات الخدمات والأدلة الإرشادية: FAQPage (صفحة الأسئلة الشائعة) وHowTo (كيفية القيام بـ...). الهدف ليس «الوصول إلى ملخصات الذكاء الاصطناعي باستخدام Schema» بقدر ما هو جعل فقرات الأسئلة والأجوبة وخطوات العمل على صفحتك ذات بنية قابلة للقراءة آليًا، ومتطابقة تمامًا مع محتوى HTML الأصلي.
وفقًا لإرشادات Google بشأن ميزات الذكاء الاصطناعي في البحث، يجب أن تكون الصفحة التي ترغب في الظهور كمصدر في ملخصات الذكاء الاصطناعي ووضع الذكاء الاصطناعي مؤهلة للظهور في بحث Google أولاً، بمعنى أنها مفهرسة ولها مقتطف. Schema لا يحل محل هذه الخطوة الأساسية. تذكر أن العديد من برامج الزحف للذكاء الاصطناعي تقرأ HTML الذي يتم إرجاعه في المرة الأولى فقط، لذا فإن المحتوى (وJSON-LD) الذي يظهر فقط بعد تشغيل JavaScript غالبًا ما يتم تجاهله.
Schema من نوع FAQPage مناسب عندما تحتوي صفحتك على مجموعة من الأسئلة التي يطرحها المستخدمون بالفعل (مثل السعر، النطاق، الالتزامات، المدة)، ولكل سؤال إجابة مستقلة. يجب أن يكون العنوان (Heading) هو السؤال، والفقرة التي تليه مباشرة هي الإجابة المختصرة، ثم يأتي الشرح التفصيلي. يجب أن يعكس JSON-LD هذا الترتيب والمحتوى بدقة. هذه المطابقة بين ما يراه المستخدم وما تقرأه الآلة هي المفتاح لتمكين الذكاء الاصطناعي من فهم واستشهاد محتواك بشكل فعال.
غالبًا ما نجد أن أداة اختبار النتائج المنسقة من Google تشير إلى أن Schema صالح، لكن الأسئلة على الصفحة مكتوبة بطريقة مطولة، أو أن الإجابات في Schema مختلفة تمامًا عما يراه القارئ، أو أن كتلة البيانات بأكملها تُضاف فقط بعد تشغيل JavaScript. في هذه الحالات، لن يساعد Schema الذكاء الاصطناعي على استخلاص المعلومات بشكل صحيح؛ بل يضيف فقط طبقة من البيانات يسهل أن تتعارض. هذا لا يخدم هدفك في الظهور بشكل جيد على محركات البحث المدعومة بالذكاء الاصطناعي.
تركز هذه النصائح على نوعين من Schema المستخدمين على نطاق واسع في صفحات الخدمات والأدلة الإرشادية: FAQPage (صفحة الأسئلة الشائعة) وHowTo (كيفية القيام بـ...). الهدف ليس «الوصول إلى ملخصات الذكاء الاصطناعي باستخدام Schema» بقدر ما هو جعل فقرات الأسئلة والأجوبة وخطوات العمل على صفحتك ذات بنية قابلة للقراءة آليًا، ومتطابقة تمامًا مع محتوى HTML الأصلي.
وفقًا لإرشادات Google بشأن ميزات الذكاء الاصطناعي في البحث، يجب أن تكون الصفحة التي ترغب في الظهور كمصدر في ملخصات الذكاء الاصطناعي ووضع الذكاء الاصطناعي مؤهلة للظهور في بحث Google أولاً، بمعنى أنها مفهرسة ولها مقتطف. Schema لا يحل محل هذه الخطوة الأساسية. تذكر أن العديد من برامج الزحف للذكاء الاصطناعي تقرأ HTML الذي يتم إرجاعه في المرة الأولى فقط، لذا فإن المحتوى (وJSON-LD) الذي يظهر فقط بعد تشغيل JavaScript غالبًا ما يتم تجاهله.
Schema من نوع FAQPage مناسب عندما تحتوي صفحتك على مجموعة من الأسئلة التي يطرحها المستخدمون بالفعل (مثل السعر، النطاق، الالتزامات، المدة)، ولكل سؤال إجابة مستقلة. يجب أن يكون العنوان (Heading) هو السؤال، والفقرة التي تليه مباشرة هي الإجابة المختصرة، ثم يأتي الشرح التفصيلي. يجب أن يعكس JSON-LD هذا الترتيب والمحتوى بدقة. هذه المطابقة بين ما يراه المستخدم وما تقرأه الآلة هي المفتاح لتمكين الذكاء الاصطناعي من فهم واستشهاد محتواك بشكل فعال.