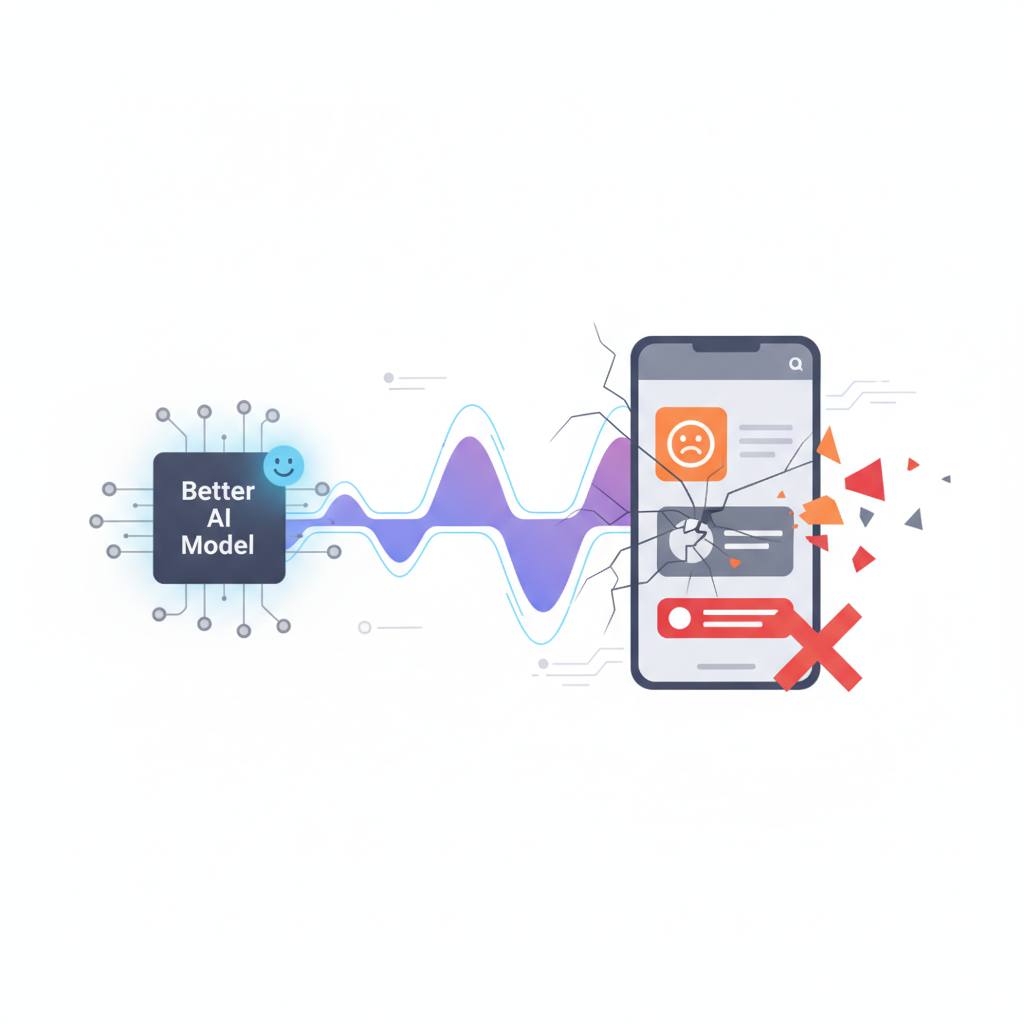
الترقية إلى نموذج ذكاء اصطناعي جديد بالاعتماد فقط على النتائج العامة يمكن أن يخفي مشاكل دقيقة في تطبيقك. يشرح هذا المنشور لماذا يعد الاختبار الشامل والمخصص للسياق أمراً حيوياً قبل نشر أي نموذج جديد، حتى لو بدا 'أفضل' نظرياً.
تخيل أن تطبيقك المفضل يستخدم مساعداً ذكياً يعمل بالذكاء الاصطناعي في الكواليس، مثل نموذج لغوي يفهم ما تكتبه. فجأة، تصدر الشركة التي توفر هذا الذكاء الاصطناعي إصداراً جديداً 'مُحسّناً'. يسجل هذا الإصدار درجات أعلى في جميع الاختبارات، والجميع يقول إنه أسرع وأفضل. لذا، يقوم المهندسون ببساطة بتبديل مُعرّف النموذج القديم بالجديد، ويجرون فحصاً سريعاً، ويبدو كل شيء على ما يرام. ثم يقومون بإطلاق التحديث.
لكن هنا تكمن المشكلة الكبيرة: ما يبدو 'أفضل' في الاختبارات العامة قد لا يكون أفضل لتطبيقك *الخاص*. فكر في الأمر هكذا: لديك محرك سيارة قديم، ويصدر محرك جديد أكثر قوة. نظرياً، هو متفوق. لكن إذا قمت بتركيبه في سيارتك دون التحقق مما إذا كان يناسبها تماماً، ويتصل بجميع أنظمتك الحالية، وما إذا كانت أجزاء سيارتك الأخرى تستطيع تحمل القوة الإضافية، فقد ينتهي بك الأمر بسيارة لا تعمل بسلاسة، أو حتى تتعطل.
هذه هي المشكلة بالذات عند ترقية نماذج الذكاء الاصطناعي. قد يكون النموذج الجديد رائعاً بشكل عام، لكن إجاباته قد تختلف قليلاً. ربما يكون أكثر إبداعاً، لكن تطبيقك يحتاج إلى استجابات دقيقة وواقعية. أو ربما تم تدريبه على بيانات أحدث، والآن يقدم إجابات لا تتوافق تماماً مع السياق القديم الذي اعتاد عليه المستخدمون. هذه التغييرات الدقيقة يمكن أن 'تدهور' نظامك بهدوء دون أن يلاحظ أحد على الفور. قد يجد المستخدمون التطبيق أقل فائدة أو دقة، مما يؤدي إلى الإحباط.
التحدي هو أن اختبار نموذج جديد بشكل صحيح في تطبيق حقيقي يستغرق وقتاً وجهداً – أكثر بكثير من مجرد إجراء بضعة طلبات سريعة. يحتاج المهندسون إلى إنشاء اختبارات محددة تحاكي كيفية تفاعل المستخدمين الفعليين مع التطبيق. يحتاجون إلى مقارنة أداء النموذج الجديد بالقديم باستخدام *بياناتهم الخاصة* و *سيناريوهاتهم الفريدة*. لسوء الحظ، غالباً ما يتم تخطي هذه الخطوة الحاسمة بسبب المواعيد النهائية الضيقة والتكلفة المتصورة للتقييم.
لذا، فإن الدرس واضح: عندما يصل نموذج ذكاء اصطناعي جديد، لا تكتفِ بالتبديل. اختبره بدقة ضمن بيئة تطبيقك الفعلية. المعايير العامة هي نقطة البداية، لكن حالة استخدامك المحددة هي الحكم النهائي. إن ضمان أن نموذج الذكاء الاصطناعي 'آمن للتشغيل في الإنتاج' هو ادعاء مختلف عن كونه 'يعمل' بشكل عام.
لكن هنا تكمن المشكلة الكبيرة: ما يبدو 'أفضل' في الاختبارات العامة قد لا يكون أفضل لتطبيقك *الخاص*. فكر في الأمر هكذا: لديك محرك سيارة قديم، ويصدر محرك جديد أكثر قوة. نظرياً، هو متفوق. لكن إذا قمت بتركيبه في سيارتك دون التحقق مما إذا كان يناسبها تماماً، ويتصل بجميع أنظمتك الحالية، وما إذا كانت أجزاء سيارتك الأخرى تستطيع تحمل القوة الإضافية، فقد ينتهي بك الأمر بسيارة لا تعمل بسلاسة، أو حتى تتعطل.
هذه هي المشكلة بالذات عند ترقية نماذج الذكاء الاصطناعي. قد يكون النموذج الجديد رائعاً بشكل عام، لكن إجاباته قد تختلف قليلاً. ربما يكون أكثر إبداعاً، لكن تطبيقك يحتاج إلى استجابات دقيقة وواقعية. أو ربما تم تدريبه على بيانات أحدث، والآن يقدم إجابات لا تتوافق تماماً مع السياق القديم الذي اعتاد عليه المستخدمون. هذه التغييرات الدقيقة يمكن أن 'تدهور' نظامك بهدوء دون أن يلاحظ أحد على الفور. قد يجد المستخدمون التطبيق أقل فائدة أو دقة، مما يؤدي إلى الإحباط.
التحدي هو أن اختبار نموذج جديد بشكل صحيح في تطبيق حقيقي يستغرق وقتاً وجهداً – أكثر بكثير من مجرد إجراء بضعة طلبات سريعة. يحتاج المهندسون إلى إنشاء اختبارات محددة تحاكي كيفية تفاعل المستخدمين الفعليين مع التطبيق. يحتاجون إلى مقارنة أداء النموذج الجديد بالقديم باستخدام *بياناتهم الخاصة* و *سيناريوهاتهم الفريدة*. لسوء الحظ، غالباً ما يتم تخطي هذه الخطوة الحاسمة بسبب المواعيد النهائية الضيقة والتكلفة المتصورة للتقييم.
لذا، فإن الدرس واضح: عندما يصل نموذج ذكاء اصطناعي جديد، لا تكتفِ بالتبديل. اختبره بدقة ضمن بيئة تطبيقك الفعلية. المعايير العامة هي نقطة البداية، لكن حالة استخدامك المحددة هي الحكم النهائي. إن ضمان أن نموذج الذكاء الاصطناعي 'آمن للتشغيل في الإنتاج' هو ادعاء مختلف عن كونه 'يعمل' بشكل عام.